Introduction
Pourquoi orchestrer, et ce que Docker Compose ne sait pas faire.
Introduction à Kubernetes
Vous savez construire une image et lancer un conteneur. Sur votre poste, docker compose up démarre une API, une base de données et un cache en quelques secondes, et tout fonctionne. Puis vient la question qui change tout : que se passe-t-il quand cette application doit tourner en continu, sur plusieurs machines, sans que personne ne se lève la nuit pour la redémarrer ?
Compose décrit un état souhaité, mais rien ne le maintient dans le temps. Si le processus plante, restart: always le relance. Si la machine tombe, plus rien ne relance quoi que ce soit. Si le trafic triple, vous démarrez des répliques à la main, leurs adresses changent, et il faut reconfigurer le reverse proxy. Si vous déployez une nouvelle version, il y a une coupure entre l’arrêt de l’ancienne et le démarrage de la nouvelle. Chacun de ces problèmes a une réponse manuelle évidente. C’est leur accumulation qui devient intenable.
La réponse de Kubernetes n’est pas « plus de commandes ». C’est une inversion de responsabilité : vous décrivez l’état que vous voulez, de façon permanente, et un ensemble de boucles de contrôle travaille en continu pour que la réalité corresponde à cette description. C’est le seul concept vraiment structurant du système : tout le reste — Pods, Deployments, Services, volumes — n’est qu’une déclinaison de cette idée sur un objet particulier.
Cette leçon pose ce modèle, puis décrit l’architecture d’un cluster. Pas par goût de la nomenclature : savoir quel composant décide quoi est ce qui vous permettra de diagnostiquer. Un Pod bloqué parce que l’ordonnanceur ne trouve aucun nœud disponible et un Pod bloqué parce que le kubelet n’arrive pas à télécharger l’image sont deux pannes qui n’ont ni la même cause ni le même endroit à regarder.
L’impératif contre le déclaratif
Avec Docker, vous donnez des ordres. Chaque commande décrit une action à exécuter maintenant :
# Impératif : je décris les actions, une par une, dans l'ordre.
docker build -t mon-api:1.2.0 .
docker run -d --name api-1 -p 8080:8080 mon-api:1.2.0
docker run -d --name api-2 -p 8081:8080 mon-api:1.2.0
docker stop api-1        # pour mettre à jour : coupure assumée
docker rm api-1
docker run -d --name api-1 -p 8080:8080 mon-api:1.3.0
Ce script fonctionne une fois. Il ne dit rien de ce qui doit rester vrai. Personne ne sait, à la lecture, s’il doit y avoir deux répliques ou trois, ni quelle version est censée tourner.
Avec Kubernetes, vous décrivez une cible. Le fichier ci-dessous ne dit pas « démarre trois conteneurs », il dit « il doit y avoir trois répliques de cette version, en permanence » :
apiVersion: apps/v1
kind: Deployment
metadata:
  name: mon-api
spec:
  replicas: 3                    # état voulu, pas une action ponctuelle
  selector:
    matchLabels:
      app: mon-api
  template:
    metadata:
      labels:
        app: mon-api
    spec:
      containers:
        - name: api
          image: mon-api:1.3.0
          ports:
            - containerPort: 8080
La différence pratique est immédiate. Tuez un des trois conteneurs : un quatrième naît quelques secondes plus tard, parce que le compte ne correspond plus à la cible. Éteignez un nœud : les répliques qu’il portait sont recréées ailleurs. Personne n’a rien commandé, un contrôleur a simplement constaté un écart.
La boucle de réconciliation
C’est le mécanisme central, et il est simple :
- Un contrôleur lit l’état voulu (ce que vous avez déclaré).
- Il observe l’état réel du cluster.
- Si les deux diffèrent, il agit pour réduire l’écart.
- Il recommence. Indéfiniment.
Il existe un contrôleur par type de responsabilité, et ils sont volontairement myopes : celui qui gère les ReplicaSets ne sait rien du réseau, celui qui gère les Services ne sait rien des volumes. Chacun surveille son propre écart. L’orchestration globale émerge de ces boucles indépendantes, elle n’est pas pilotée par un chef d’orchestre unique.
Cette architecture a une conséquence qu’il faut accepter tôt : Kubernetes est asynchrone. Quand kubectl apply vous répond, il n’a rien déployé, il a seulement enregistré votre intention. Le travail réel se fait après, et peut échouer après. C’est pourquoi on ne vérifie jamais un déploiement sur le retour de apply, mais toujours sur l’état observé :
# apply enregistre l'intention : le retour ne prouve rien sur l'exécution.
kubectl apply -f deployment.yaml

# La vérification se fait sur l'état réel, ensuite.
kubectl get deployment mon-api
kubectl get pods -l app=mon-api

# Et si un Pod ne démarre pas, la raison est dans les événements de fin de description.
kubectl describe pod mon-api-7d4b8c9f5-xk2mp
L’architecture d’un cluster
Un cluster se divise en deux rôles : le plan de contrôle (control plane), qui décide, et les nœuds de travail (worker nodes), qui exécutent.
Le plan de contrôle
| Composant | Rôle | Ce que ça implique en panne |
|---|---|---|
kube-apiserver | Unique porte d’entrée. Valide et persiste toute demande. | Plus aucune modification possible ; les charges déjà lancées continuent de tourner. |
etcd | Base clé-valeur qui stocke l’état voulu et l’état observé. | Perte d’etcd sans sauvegarde = perte du cluster logique. |
kube-scheduler | Choisit sur quel nœud placer chaque nouveau Pod. | Les nouveaux Pods restent en Pending. |
kube-controller-manager | Exécute les boucles de réconciliation. | Plus d’autoréparation : les Pods morts ne sont pas remplacés. |
Le point notable : kubectl ne parle qu’à l’API server. Il n’ouvre aucune connexion vers un nœud, ne pilote aucun conteneur. Toute la sécurité et toute la traçabilité passent donc par un seul point.
Les nœuds de travail
Sur chaque nœud tournent trois éléments :
- kubelet : l’agent qui reçoit la liste des Pods à faire tourner sur son nœud, demande au runtime de les démarrer, exécute les sondes de santé et remonte l’état.
- runtime de conteneurs :
containerdouCRI-Ole plus souvent. C’est lui qui télécharge les images et lance les processus. Vos images Docker fonctionnent sans modification : elles respectent le format OCI, que ces runtimes savent lire. - kube-proxy : programme les règles réseau du nœud pour que l’adresse stable d’un Service atteigne les bons Pods.
# Voir les nœuds et leur état vu du plan de contrôle
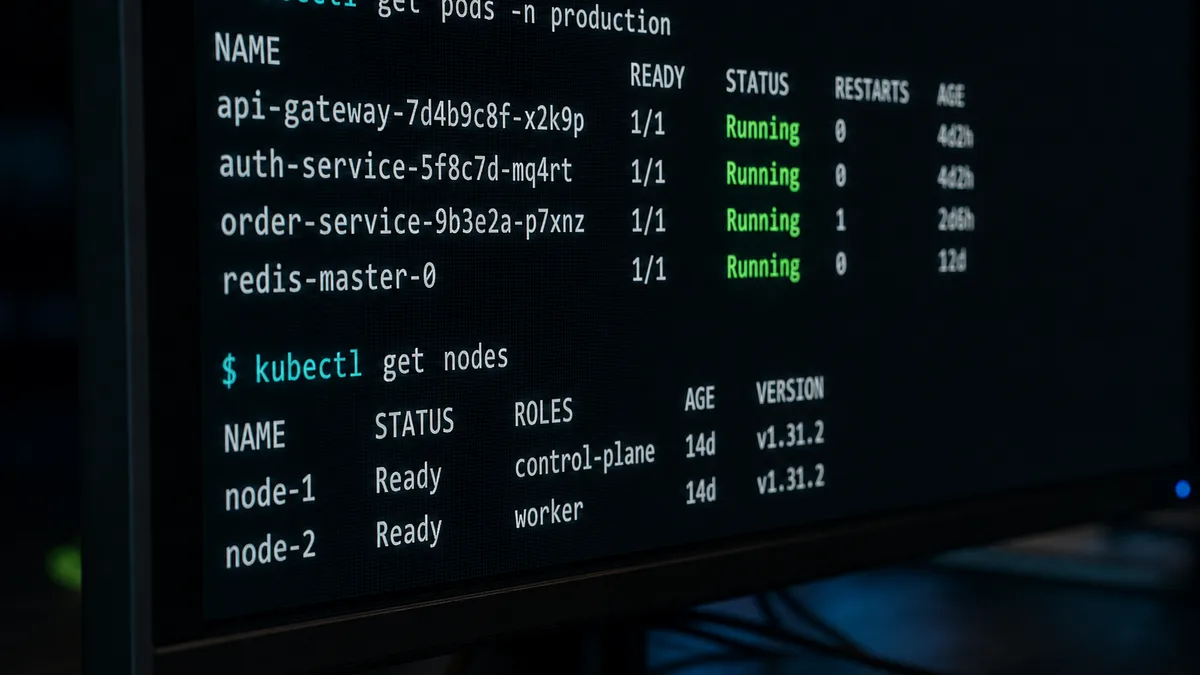
kubectl get nodes

# Détail d'un nœud : capacité, ressources déjà réservées, conditions
kubectl describe node minikube

# Les composants du plan de contrôle sont eux-mêmes des Pods, dans kube-system
kubectl get pods -n kube-system
Cette dernière commande mérite une pause : le plan de contrôle est administré par Kubernetes lui-même. Ce n’est pas une coquetterie, c’est ce qui rend ses composants observables et réparables avec les mêmes outils que vos applications.
Le Pod, et pourquoi ce n’est pas un conteneur
Kubernetes ne déploie pas des conteneurs. Il déploie des Pods. Un Pod est un groupe d’un ou plusieurs conteneurs qui partagent le même espace réseau et peuvent partager des volumes. Les conteneurs d’un même Pod se joignent sur localhost et sont toujours placés sur le même nœud.
apiVersion: v1
kind: Pod
metadata:
  name: demo-pod
  labels:
    app: demo
spec:
  containers:
    - name: web
      image: nginx:1.27-alpine
      ports:
        - containerPort: 80
Pourquoi cette couche intermédiaire ? Parce que certains besoins sont inséparables du processus principal : un collecteur de logs qui lit le même répertoire, un proxy qui termine le TLS avant l’application. Les traiter comme des conteneurs indépendants obligerait à garantir leur colocalisation par des moyens détournés. Le Pod rend cette garantie explicite.
Deuxième point, plus important en pratique : un Pod est jetable. Il n’a pas de nom stable, son adresse IP change à chaque recréation, et rien ne survit à sa disparition. On ne crée donc presque jamais un Pod directement — le manifeste ci-dessus est un exemple pédagogique, pas un modèle de production. On crée un Deployment, qui crée et remplace les Pods pour vous. La leçon 3 détaille cet enchaînement.
Ce que vous gagnez, ce que vous payez
Kubernetes apporte, sans que vous ayez à l’écrire :
- l’autoréparation : Pods et nœuds défaillants remplacés automatiquement ;
- la découverte de services : un nom DNS stable devant un ensemble de Pods mouvants ;
- les mises à jour progressives avec retour arrière, sans coupure ;
- la mise à l’échelle manuelle ou automatique selon la charge mesurée ;
- la répartition sous contrainte : l’ordonnanceur place les Pods en fonction du CPU et de la mémoire réellement disponibles.
L’autoréparation se vérifie en une manipulation, et c’est la démonstration la plus parlante du modèle déclaratif :
# On supprime une réplique à la main…
kubectl delete pod mon-api-7d4b8c9f5-xk2mp

# …et le compte est déjà rétabli, avec un Pod au suffixe différent.
kubectl get pods -l app=mon-api
Le coût est réel et il faut le nommer. Kubernetes ajoute une couche d’abstraction qui a sa propre complexité : plus de concepts à connaître, plus de configuration YAML, un cluster à maintenir ou à payer, et une boîte à outils de diagnostic à apprendre. Pour un site vitrine sur une machine, docker compose reste le bon choix, et prétendre le contraire serait malhonnête. Kubernetes devient rentable quand vous avez plusieurs services, une exigence de disponibilité, ou plusieurs équipes qui déploient sur la même infrastructure.
Le vocabulaire commun à tous les manifestes
Tout objet Kubernetes, quel que soit son type, s’écrit avec les mêmes quatre champs de premier niveau. Les reconnaître rend n’importe quel manifeste lisible :
apiVersion: apps/v1      # groupe et version de l'API qui définit ce type
kind: Deployment         # le type d'objet
metadata:                # identité : nom, namespace, labels, annotations
  name: mon-api
  labels:
    app: mon-api
spec:                    # l'état voulu ; son contenu dépend du kind
  replicas: 3
Une seule règle d’apiVersion à retenir pour ce cours, et elle évite l’erreur la plus fréquente du débutant :
v1pour Pod, Service, ConfigMap, Secret, PersistentVolume, PersistentVolumeClaim ;apps/v1pour Deployment, ReplicaSet, StatefulSet, DaemonSet.
Un apiVersion: v1 sur un Deployment est rejeté par l’API server avec un message peu explicite. La liste exacte pour un type donné se lit directement depuis le cluster :
# Quel apiVersion pour ce type ? La réponse vient du cluster, pas de la mémoire.
kubectl api-resources | grep -i deployment

# Documentation d'un champ, sans quitter le terminal
kubectl explain deployment.spec.strategy
kubectl explain est l’outil le plus sous-utilisé de l’écosystème. Il décrit les champs de la version de l’API réellement installée sur votre cluster, ce qu’aucun article de blog ne peut garantir.
Ce que couvre la suite du cours
- Installation et configuration — un cluster local avec minikube ou kind,
kubectl, contextes et namespaces. - Pods, Services et Deployments — les ressources du quotidien, les sélecteurs de labels, les mises à jour progressives et les sondes.
- ConfigMaps et Secrets — sortir la configuration des images, et ce que « Secret » ne signifie pas.
- Stockage persistant — volumes, réclamations, StorageClass et StatefulSet.
- Déploiement d’applications complexes — multi-services, Ingress, ressources, autoscaling, aperçu de Helm.
Tous ces objets sont déjà connus de votre futur cluster. Cette commande les liste avec leur nom abrégé, celui que vous taperez au quotidien :
kubectl api-resources | grep -E 'deployments|services|configmaps|secrets|persistentvolumeclaims'
# deployments   deploy   apps/v1   true   Deployment
# services      svc      v1        true   Service
# configmaps    cm       v1        true   ConfigMap
À retenir
- Kubernetes est déclaratif : vous décrivez un état voulu, des boucles de réconciliation le maintiennent.
applyenregistre une intention, il ne garantit pas un résultat — la vérification se fait toujours sur l’état observé. - Le plan de contrôle décide (API server, etcd, scheduler, controller-manager), les nœuds exécutent (kubelet, runtime, kube-proxy). Savoir qui fait quoi est la base du diagnostic.
- L’unité déployée est le Pod, pas le conteneur : un groupe colocalisé partageant réseau et volumes, et surtout jetable. On le crée via un contrôleur, jamais à la main en production.
- Tous les manifestes partagent
apiVersion,kind,metadata,spec. Retenezv1pour Pod/Service/ConfigMap/Secret/PVC etapps/v1pour Deployment/StatefulSet. - L’orchestration a un coût de complexité assumé. Elle se justifie par le nombre de services, l’exigence de disponibilité et le nombre d’équipes, pas par la mode.
Référence : la documentation officielle est en français pour une bonne partie des concepts. Gardez kubernetes.io/fr/docs/concepts/ ouvert pendant ce cours.
Commentaires
Les commentaires sont alimentés par GitHub Discussions
Connectez-vous avec GitHub pour participer à la discussion